SK하이닉스, 메모리 중심 서버 랙 '마스' 시연
(서울=연합인포맥스) 한종화 기자 = SK하이닉스[000660]가 글로벌 슈퍼컴퓨팅 컨퍼런스에서 차세대 기술을 집약한 메모리 중심의 서버 랙(rack)을 선보였다.
SK하이닉스는 15일부터 20일까지(현지시간) 미국 일리노이주 시카고에서 열린 '슈퍼 컴퓨팅 2026'에서 메모리 중심으로 파트너사의 솔루션을 통합한 AI 랙 시스템 '마스(MARS)'를 전시했다.
마스가 선보인 데모는 컴퓨트익스프레스링크(CXL) 메모리와 CXL 하이브리드 메모리를 묶어 랙 단위로 키밸류(KV) 캐시를 공유하는 풀드 메모리(Pooled Memory)다.
지속적으로 생성되는 대규모 KV 캐시는 CXL 하이브리드 메모리 내 SSD에 저장하고, 이를 재사용할 때는 D램으로 빠르게 가져오는 방식이다.
이를 통해 AI 구동에 필요한 방대한 정보를 저장할 수 있는 대용량 스토리지를 확보하면서 동시에 빠른 읽기 성능도 구현할 수 있었다.
SK하이닉스는 두 번째 데모로 연산형 풀드 메모리로 여러 서버와 그래픽처리장치(GPU)를 연결해 효율성을 높인 'AI 에이전트 서빙 시스템'을 시연했다.
연산형 풀드 메모리는 메모리 풀 내부에 연산 기능을 더해 데이터를 중앙처리장치(CPU)나 GPU로 보내기 전 간단한 연산 처리를 수행할 수 있는 메모리 솔루션이다.
SK하이닉스의 AI 에이전트 서빙 시스템은 CXL 기반 연산형 풀드 메모리를 활용해 KV 캐시를 선택적으로 전달하거나 재사용할 경우 기존 방식보다 시스템 성능을 크게 높일 수 있음을 입증했다.
세 번째 데모에서는 CXL 풀드 메모리로 연결된 CPU 서버들이 생성한 토큰을 공유하는 방식으로 멀티모달 AI 서비스의 성능을 높이는 과정을 선보였다.
멀티모달은 텍스트와 이미지, 음성, 영상 등 서로 다른 형태의 데이터를 함께 이해하고 처리하는 AI 기술이다.
멀티모달 AI 서비스의 경우 토큰화 시간이 성능에 큰 영향을 미친다. 토큰화는 AI 모델이 처리할 수 있도록 텍스트나 이미지 등의 데이터를 토큰이라는 최소 단위로 잘게 나누는 과정이다.
SK하이닉스는 CXL 풀드 메모리로 중앙처리장치(CPU) 서버 간 요청 데이터와 토큰을 공유해 중복 처리를 줄였다. 그 결과 GPU 대기 시간은 단축됐고, 서빙 성능은 한층 향상됐다.
SK하이닉스 관계자는 "메모리가 AI 인프라의 성능과 효율을 좌우하는 요소로 떠오르는 가운데 이번 전시를 통해 회사의 기술 경쟁력과 AI 메모리 비전을 선명하게 전할 수 있었다"며 "앞으로도 AI 컴퓨팅 성능을 높여 갈 핵심 기술 파트너로서 고객과 함께 성장해 나가겠다"고 강조했다.
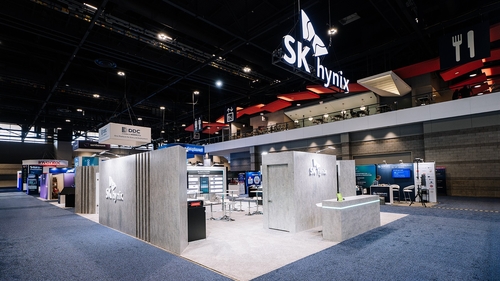
[출처 : SK하이닉스 뉴스룸]
jhhan@yna.co.kr

한종화
jhhan@yna.co.kr
함께 보면 도움이 되는
뉴스를 추천해요


